Configuración del plugin
Configuración del modelo
Para un funcionamiento fiable con los modelos Realistic y Mood-Enabled Realistic, vuelve a crear el generador antes de cada nueva reproducción de audio en lugar de reutilizar uno durante silencios prolongados. Consulta Recreación del generador en Solución de problemas para más detalles.
Configuración del modelo estándar
El nodo Create Runtime Viseme Generator utiliza ajustes predeterminados que funcionan bien para la mayoría de los escenarios. La configuración se gestiona a través de las propiedades del nodo de mezcla del Animation Blueprint.
Para las opciones de configuración de Animation Blueprint, consulte la sección Lip Sync Configuration a continuación.
Configuración del modelo realista
El nodo Create Realistic MetaHuman Lip Sync Generator acepta un parámetro opcional Configuration que te permite personalizar el comportamiento del generador:
Tipo de modelo
El ajuste Model Type determina qué versión del modelo realista usar:
| Tipo de modelo | Rendimiento | Calidad visual | Manejo del ruido | Casos de uso recomendados |
|---|---|---|---|---|
| Altamente optimizado (Predeterminado) | Máximo rendimiento, menor uso de CPU | Buena calidad | Puede mostrar movimientos de boca notables con ruido de fondo o sonidos que no son voz | Entornos de audio limpios, escenarios críticos para el rendimiento |
| Semioptimizado | Buen rendimiento, uso moderado de CPU | Alta calidad | Mayor estabilidad con audio ruidoso | Rendimiento y calidad equilibrados, condiciones de audio mixtas |
| Original | Adecuado para uso en tiempo real en CPUs modernas | Máxima calidad | Mayor estabilidad con ruido de fondo y sonidos que no son voz | Producciones de alta calidad, entornos de audio ruidosos, cuando se necesita la máxima precisión |
Configuración de rendimiento
Subprocesos intraoperativos: Controla el número de subprocesos utilizados para las operaciones internas de procesamiento del modelo.
- 0 (Predeterminado/Automático): Utiliza detección automática (normalmente 1/4 de los núcleos de CPU disponibles, máximo 4)
- 1-16: Especifica manualmente el número de hilos. Valores más altos pueden mejorar el rendimiento en sistemas multinúcleo pero consumen más CPU
Hilos de interoperación: Controla el número de hilos utilizados para la ejecución paralela de las distintas operaciones del modelo.
- 0 (Predeterminado/Automático): Utiliza detección automática (normalmente 1/8 de los núcleos de CPU disponibles, máximo 2)
- 1-8: Especifica manualmente el número de hilos. Normalmente se mantiene bajo para el procesamiento en tiempo real
Tamaño del fragmento de procesamiento
El Processing Chunk Size determina cuántas muestras se procesan en cada paso de inferencia. El valor predeterminado es 160 muestras (10 ms de audio a 16 kHz):
- Los valores más pequeños proporcionan actualizaciones más frecuentes pero aumentan el uso de CPU
- Los valores más grandes reducen la carga de CPU pero pueden disminuir la capacidad de respuesta del lip sync
- Se recomienda usar múltiplos de 160 para una alineación óptima

Configuración del modelo con control de estado de ánimo
El nodo Create Realistic MetaHuman Lip Sync With Mood Generator proporciona opciones de configuración adicionales más allá del modelo realista básico:
Configuración básica
Lookahead Ms: Tiempo de anticipación en milisegundos para mejorar la precisión de la sincronización labial.
- Predeterminado: 80 ms
- Rango: 20 ms a 200 ms (debe ser divisible por 20)
- Los valores más altos proporcionan una mejor sincronización pero aumentan la latencia
Tipo de salida: Controla qué controles faciales se generan.
- Rostro completo: Los 81 controles faciales (cejas, ojos, nariz, boca, mandíbula, lengua)
- Solo boca: Solo los controles relacionados con la boca, la mandíbula y la lengua
Configuración de rendimiento: Utiliza los mismos ajustes de Intra Op Threads e Inter Op Threads que el modelo realista normal.
Configuración de estados de ánimo
Estados de ánimo disponibles:
- Neutral, Feliz, Triste, Disgusto, Enfado, Sorpresa, Miedo
- Seguro, Emocionado, Aburrido, Juguetón, Confundido
Intensidad del estado de ánimo: Controla con qué fuerza el estado de ánimo afecta a la animación (0.0 a 1.0)
Control de estado de ánimo en tiempo de ejecución
Puedes ajustar la configuración de estado de ánimo durante el tiempo de ejecución usando las siguientes funciones:
- Establecer estado de ánimo: Cambia el tipo de estado de ánimo actual
- Establecer intensidad del estado de ánimo: Ajusta con qué fuerza el estado de ánimo afecta a la animación (0.0 a 1.0)
- Establecer Lookahead Ms: Modifica la temporización de anticipación para la sincronización
- Establecer tipo de salida: Alterna entre los controles Full Face y Mouth Only

Guía de selección de estado de ánimo
Elige estados de ánimo adecuados según tu contenido:
| Mood | Ideal para | Rango de intensidad típico |
|---|---|---|
| Neutral | Conversación general, narración, estado predeterminado | 0.5 - 1.0 |
| Alegre | Contenido positivo, diálogo animado, celebraciones | 0.6 - 1.0 |
| Triste | Contenido melancólico, escenas emotivas, momentos sombríos | 0.5 - 0.9 |
| Disgusto | Reacciones negativas, contenido desagradable, rechazo | 0.4 - 0.8 |
| Ira | Diálogo agresivo, escenas de confrontación, frustración | 0.6 - 1.0 |
| Sorpresa | Eventos inesperados, revelaciones, reacciones de impacto | 0.7 - 1.0 |
| Miedo | Situaciones amenazantes, ansiedad, diálogo nervioso | 0.5 - 0.9 |
| Seguro | Presentaciones profesionales, diálogo de liderazgo, habla asertiva | 0.7 - 1.0 |
| Emocionado | Contenido energético, anuncios, diálogo entusiasta | 0.8 - 1.0 |
| Aburrido | Contenido monótono, diálogo desinteresado, habla cansada | 0.3 - 0.7 |
| Juguetón | Conversación informal, humor, interacciones desenfadadas | 0.6 - 0.9 |
| Confundido | Diálogo con muchas preguntas, incertidumbre, desconcierto | 0.4 - 0.8 |
Configuración de Animation Blueprint
Configuración de Lip Sync
- Modelo estándar
- Modelos realistas
El nodo Blend Runtime MetaHuman Lip Sync tiene opciones de configuración en su panel de propiedades:
| Propiedad | Predeterminado | Descripción |
|---|---|---|
| Velocidad de interpolación | 25 | Controla la rapidez con la que los movimientos de los labios transicionan entre visemas. Los valores más altos producen transiciones más rápidas y abruptas. |
| Tiempo de reinicio | 0.2 | La duración en segundos tras la cual se reinicia la sincronización labial. Esto es útil para evitar que la sincronización labial continúe después de que el audio se haya detenido. |
Animación de risa
También puedes añadir animaciones de risa que responderán dinámicamente a la risa detectada en el audio:
- Añade el nodo
Blend Runtime MetaHuman Laughter - Conecta tu variable
RuntimeVisemeGeneratoral pinViseme Generator - Si ya estás usando lip sync:
- Conecta la salida del nodo
Blend Runtime MetaHuman Lip SyncalSource Posedel nodoBlend Runtime MetaHuman Laughter - Conecta la salida del nodo
Blend Runtime MetaHuman Laughteral pinResultdelOutput Pose
- Conecta la salida del nodo
- Si se usa solo la risa sin sincronización labial:
- Conecta tu pose de origen directamente al
Source Posedel nodoBlend Runtime MetaHuman Laughter - Conecta la salida al pin
Result
- Conecta tu pose de origen directamente al

Cuando se detecta risa en el audio, tu personaje se animará dinámicamente en consecuencia:
Configuración de risa
El nodo Blend Runtime MetaHuman Laughter tiene sus propias opciones de configuración:
| Propiedad | Predeterminado | Descripción |
|---|---|---|
| Velocidad de interpolación | 25 | Controla la rapidez con la que los movimientos de los labios realizan la transición entre las animaciones de risa. Los valores más altos dan como resultado transiciones más rápidas y abruptas. |
| Tiempo de reinicio | 0.2 | La duración en segundos tras la cual se reinicia la risa. Esto es útil para evitar que la risa continúe después de que el audio se haya detenido. |
| Peso máximo de la risa | 0.7 | Escala la intensidad máxima de la animación de risa (0.0 - 1.0). |
Nota: La detección de risas actualmente solo está disponible con el modelo Standard.
El nodo Blend Realistic MetaHuman Lip Sync tiene opciones de configuración en su panel de propiedades:
| Propiedad | Predeterminado | Descripción |
|---|---|---|
| Velocidad de interpolación | 30 | Controla la rapidez con la que las expresiones faciales cambian durante el habla activa. Los valores más altos producen transiciones más rápidas y abruptas. |
| Velocidad de interpolación en reposo | 15 | Controla la rapidez con la que las expresiones faciales vuelven al estado de reposo/neutral. Los valores más bajos producen retornos más suaves y graduales a la pose de reposo. |
| Tiempo de reinicio | 0.2 | Duración en segundos tras la cual el lip sync se reinicia al estado de reposo. Útil para evitar que las expresiones continúen después de que se detenga el audio. |
| Preservar estado de reposo | false | Cuando está habilitado, conserva el último estado emocional durante los periodos de reposo en lugar de reiniciarse al estado neutral. |
| Preservar expresiones oculares | true | Controla si los controles faciales relacionados con los ojos se conservan durante el estado de reposo. Solo tiene efecto cuando Preservar estado de reposo está habilitado. |
| Preservar expresiones de cejas | true | Controla si los controles faciales relacionados con las cejas se conservan durante el estado de reposo. Solo tiene efecto cuando Preservar estado de reposo está habilitado. |
| Preservar forma de la boca | false | Controla si los controles de forma de la boca (excluyendo los movimientos específicos del habla como la lengua y la mandíbula) se conservan durante el estado de reposo. Solo tiene efecto cuando Preservar estado de reposo está habilitado. |
Preservación del estado inactivo
La función Preserve Idle State aborda cómo el modelo Realistic gestiona los periodos de silencio. A diferencia del modelo Standard, que utiliza visemas discretos y vuelve sistemáticamente a valores cero durante el silencio, la red neuronal del modelo Realistic puede mantener una sutil posición facial que difiere de la pose de reposo predeterminada del MetaHuman.
Cuándo habilitarlo:
- Mantener las expresiones emocionales entre segmentos de habla
- Preservar los rasgos de personalidad del personaje
- Garantizar la continuidad visual en secuencias cinematográficas
Opciones de control regional:
- Expresiones oculares: Conserva el entrecerrado, la apertura y la posición de los párpados
- Expresiones de las cejas: Mantiene la posición de las cejas y la frente
- Forma de la boca: Conserva la curvatura general de la boca mientras permite que los movimientos del habla (lengua, mandíbula) se restablezcan
Combinación con animaciones existentes
¿Prefieres verlo antes que leerlo? Echa un vistazo al videotutorial que cubre esta misma configuración.
Para aplicar la sincronización labial y la risa junto con las animaciones corporales existentes y las animaciones faciales personalizadas sin sobrescribirlas:
Esta configuración se aplica al Animation Blueprint de la cara, ya que la sincronización labial no forma parte del Animation Blueprint del cuerpo. Para animaciones corporales personalizadas (por ejemplo, torso, brazos y otros movimientos del cuerpo), simplemente conecta tu secuencia de animación (mediante un Sequence Player) directamente a la pose de salida en el Animation Blueprint del cuerpo. No se necesita ninguna configuración adicional allí.
- Añade un nodo
Layered blend per boneentre tus animaciones de cuerpo y la salida final. - Configura la configuración de capas:
- Añade 1 elemento al array
Layer Setup - Añade 3 elementos a los
Branch Filtersde la capa, con los siguientesBone Names:FACIAL_C_FacialRootFACIAL_C_Neck2RootFACIAL_C_Neck1Root
- Añade 1 elemento al array
- Importante para las animaciones faciales personalizadas: En
Curve Blend Option, selecciona "Use Max Value". Esto permite que las animaciones faciales personalizadas (expresiones, emociones, etc.) se superpongan correctamente sobre el lip sync. - Realiza las conexiones:
- Tu animación personalizada (normalmente un
Sequence Playercon el recurso de secuencia de animación deseado) → entradaBase Pose - Salida de animación facial (de los nodos de lip sync y/o risa) → entrada
Blend Poses 0 - Nodo de mezcla por capas → pose
Resultfinal
- Tu animación personalizada (normalmente un

Selección de conjunto de Morph Targets
- Modelo estándar
- Modelos realistas
El modelo estándar utiliza pose assets que admiten inherentemente cualquier convención de nombres de morph target mediante la configuración personalizada de pose asset. No se necesita configuración adicional.
El nodo Blend Realistic MetaHuman Lip Sync incluye una propiedad Morph Target Set que determina qué convención de nombres de morph target usar para la animación facial:
| Conjunto de morph targets | Descripción | Casos de uso |
|---|---|---|
| MetaHuman (predeterminado) | Nombres estándar de morph targets de MetaHuman (p. ej., CTRL_expressions_jawOpen) | Personajes MetaHuman |
| ARKit | Nombres compatibles con Apple ARKit (p. ej., JawOpen, MouthSmileLeft) | Personajes basados en ARKit |
Conversión de personajes a blendshapes de ARKit o MetaHuman
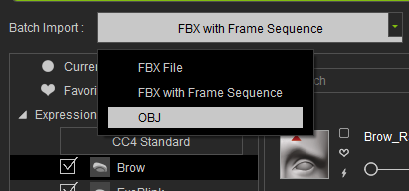
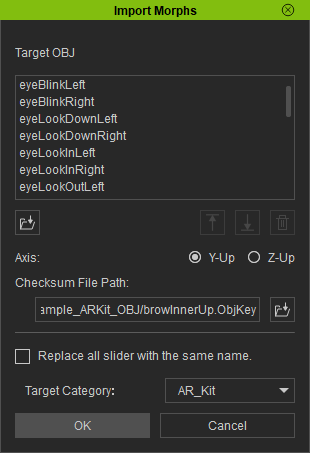
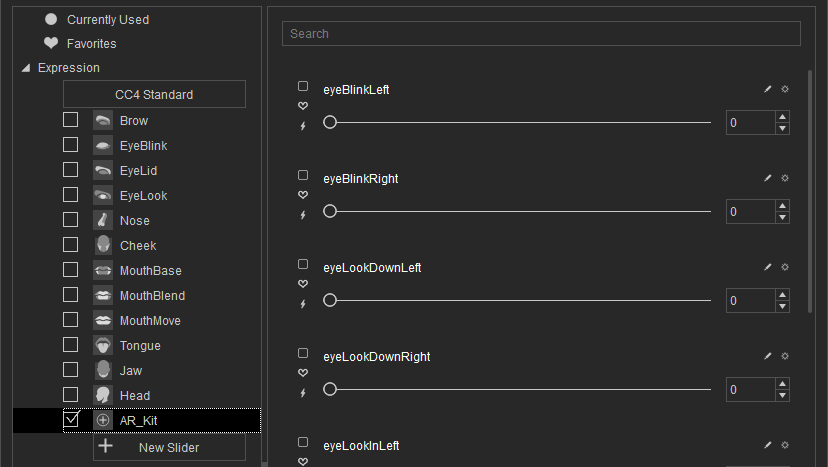
Si tu personaje no utiliza de forma nativa los nombres de blendshapes estándar de ARKit, varios sistemas comerciales de personajes populares pueden convertirse para producirlos (o, en el caso de CC5, convertirse directamente a blendshapes nativos de MetaHuman). Esto te da acceso al ARKit o al MetaHuman Morph Target Set anterior, en lugar del proceso de mapeo manual de visemas requerido para el Standard Model. Los personajes CC4 y CC5 se manejan de forma diferente aquí, ya que los personajes CC5 pueden compartir el rig facial nativo de MetaHuman en lugar de necesitar una conversión a ARKit. CC5: convertir a blendshapes de MetaHuman (recomendado) Si tu personaje está creado en CC5 con el perfil facial HD, ya comparte los controles faciales y el esqueleto de MetaHuman, así que no es necesario generar los blendshapes de ARKit manualmente. Mira el vídeo a continuación para ver el flujo de trabajo completo de exportación/importación usando el plugin gratuito Auto Setup (All-in-One) de Reallusion: Una vez importado, selecciona la opción MetaHuman Morph Target Set en lugar de ARKit, ya que los blendshapes del personaje ya utilizan la nomenclatura nativa de MetaHuman. CC4 (o CC5 sin el perfil HD): convertir a blendshapes de ARKit Si estás en CC4, o en un personaje CC5 que no utiliza el perfil facial HD, usa en su lugar la conversión manual de ARKit. Antes de comenzar, asegúrate de que el Facial Profile de tu personaje esté configurado en CC4 Extended (no en Standard, Extended-Plus ni el nuevo HD Facial Profile). El mapeo de blendshapes del script está codificado de forma fija con los nombres de los deslizadores de Extended; otros perfiles usan convenciones de nombres diferentes y el script omitirá silenciosamente o no encontrará los deslizadores esperados. Descarga este script: Abre el script en un editor de texto y, donde dice En Character Creator, elige tu personaje, luego en el menú superior bajo Script selecciona Load Python. Después selecciona el script que acabas de editar. El script ahora creará el conjunto completo de blendshapes de ARKit a partir de los deslizadores predeterminados de Reallusion y los exportará como archivos OBJ. Esto puede tardar unos minutos. Ahora puedes importar esas formas yendo a la ventana Facial Profile Editor. Haz clic en el botón Edit Expressions y en el menú desplegable Batch Import selecciona OBJ. Aquí puedes importar la carpeta a la que hiciste referencia anteriormente. Esto luego listará todas las formas de ARKit. Escribe un nombre en la Target Category, por ejemplo AR_Kit, y haz clic en OK. Esto habrá creado una nueva categoría bajo Expression. Puedes desactivar todas las demás categorías. Una vez configurada la categoría ARKit, exporta tu personaje como FBX como de costumbre. Esto le proporciona al personaje los 52 blendshapes estándar de ARKit, que luego puedes usar con la opción ARKit Morph Target Set de arriba. Nota: el movimiento de la mandíbula se debe en parte a la rotación de huesos en lugar de a blendshapes puros en el rig de CC4, por lo que Los morphs FACS de Daz, disponibles de forma nativa en Genesis 8.1 y Genesis 9, ya son compatibles con ARKit sin necesidad de renombrarlos. Genesis 8 simple (no 8.1) no los incluye por defecto. Deberás usar Genesis 8.1 en su lugar, o añadir un paquete de morphs FACS por separado. El complemento Diffeomorphic, que se mantiene activamente (un puente entre Daz Studio y Blender, no afiliado a Daz 3D), es la forma recomendada de incorporarlos en Unreal: Una vez exportado, utiliza la opción ARKit Morph Target Set de arriba. Nota: las formas de dirección de la mirada en las pestañas y los globos oculares pueden no transferirse por completo, ya que se controlan de forma diferente a la malla facial principal, pero esto no afecta al lip sync, que solo necesita las formas de la boca y la mandíbula.Guías de conversión de Reallusion CC4/CC5 y Daz Genesis 8.1/9 (haz clic para expandir)
rl_export_arkit_objs.pyoutput_dir = "path/to/your/target/folder", asigna la ruta a tu carpeta de exportación. Asegúrate de usar barras diagonales /.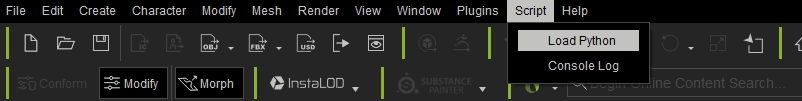
jawOpen puede verse débil o no abrir la boca de forma convincente tras la exportación. Si esto ocurre, activa Mouth Open as Morph en las opciones de exportación de FBX; esto hornea el movimiento de la mandíbula impulsado por huesos en un blendshape dedicado que se puede asignar como fuente para jawOpen en lugar del predeterminado. O bien, el complemento cc_blender_tools puede hacer pasar el personaje por Blender para corregir esto y otros problemas de formas; consulta la sección "Blender Round Trip" de su documentación para conocer el flujo de trabajo (el título de la página menciona Unity, pero esta sección específica es independiente del motor).
Ajuste fino del comportamiento de Lip Sync
Escalado de curvas de Lip Sync específicas
Puedes atenuar (o amplificar) movimientos faciales individuales producidos por el lip sync usando un nodo Modify Curve. Esto es útil cuando una curva en particular se ve demasiado pronunciada para tu contenido de audio o personaje.
Configuración:
- Después de tu nodo de mezcla de lip sync, añade un nodo
Modify Curve - Haz clic derecho en el nodo y selecciona Add Curve Pin, luego introduce el nombre de la curva que quieres escalar
- Establece la propiedad Apply Mode del nodo en Scale
- Establece el parámetro Value: los valores por debajo de 1.0 atenúan el movimiento, los valores por encima de 1.0 lo amplifican (p. ej., 0.8 = 20 % de reducción)
Curvas escaladas comunes:
| Nombre de la curva | Propósito | Se aplica a | Ajuste típico |
|---|---|---|---|
CTRL_expressions_tongueOut | Protrusión de la lengua hacia delante durante ciertos fonemas | Modelo estándar | 0.8 para reducir la protrusión |
CTRL_expressions_jawOpen | Rango de apertura de la mandíbula | Modelos realistas | 0.9 para reducir el movimiento de la mandíbula |
Puedes añadir varios pines de curva al mismo nodo Modify Curve para escalar varias curvas a la vez.
Ajuste fino específico por estado de ánimo
Para los modelos con control de estado de ánimo, puedes ajustar con precisión expresiones emocionales específicas:
Control de cejas:
CTRL_expressions_browRaiseInL/CTRL_expressions_browRaiseInR- Elevación de la ceja interiorCTRL_expressions_browRaiseOuterL/CTRL_expressions_browRaiseOuterR- Elevación de la ceja exteriorCTRL_expressions_browDownL/CTRL_expressions_browDownR- Descenso de la ceja
Control de expresión ocular:
CTRL_expressions_eyeSquintInnerL/CTRL_expressions_eyeSquintInnerR- Entrecerrado de ojosCTRL_expressions_eyeCheekRaiseL/CTRL_expressions_eyeCheekRaiseR- Elevación de mejillas
Comparación y selección de modelos
Elegir entre modelos
Al decidir qué modelo de lip sync usar para tu proyecto, considera estos factores:
| Consideración | Modelo estándar | Modelo realista | Modelo realista con estados de ánimo |
|---|---|---|---|
| Compatibilidad de personajes | MetaHumans y todos los tipos de personajes personalizados | Personajes MetaHumans (y ARKit) | Personajes MetaHumans (y ARKit) |
| Calidad visual | Buena sincronización labial con rendimiento eficiente | Realismo mejorado con movimientos de boca más naturales | Realismo mejorado con expresiones emocionales |
| Rendimiento | Optimizado para todas las plataformas, incluidas móvil/VR | Mayores requisitos de recursos | Mayores requisitos de recursos |
| Características | 14 visemas, detección de risa | 81 controles faciales, 3 niveles de optimización | 81 controles faciales, 12 estados de ánimo, salida configurable |
| Compatibilidad de plataformas | Windows, Android, Quest | Windows, Mac, iOS, Linux, Android, Quest | Windows, Mac, iOS, Linux, Android, Quest |
| Casos de uso | Aplicaciones generales, juegos, VR/AR, móvil | Experiencias cinematográficas, interacciones en primer plano | Narración emocional, interacción avanzada con personajes |
Compatibilidad de versiones del motor
Si usas Unreal Engine 5.2, los modelos realistas pueden no funcionar correctamente debido a un error en la biblioteca de remuestreo de UE. Para los usuarios de UE 5.2 que necesiten una funcionalidad de lip sync fiable, utilicen el modelo estándar en su lugar.
Este problema es específico de UE 5.2 y no afecta a otras versiones del motor.
Recomendaciones de rendimiento
- Para la mayoría de los proyectos, el Modelo estándar ofrece un excelente equilibrio entre calidad y rendimiento
- Utiliza el Modelo realista cuando necesites la máxima fidelidad visual para personajes MetaHuman
- Utiliza el Modelo realista con control de estados de ánimo cuando el control de la expresión emocional sea importante para tu aplicación
- Ten en cuenta las capacidades de rendimiento de tu plataforma objetivo al elegir entre modelos
- Prueba diferentes niveles de optimización para encontrar el mejor equilibrio para tu caso de uso específico
Solución de problemas
Problemas comunes
Recreación del generador para modelos realistas: Para un funcionamiento fiable y consistente con los modelos realistas, se recomienda recrear el generador cada vez que quieras introducir nuevos datos de audio tras un periodo de inactividad. Esto se debe al comportamiento del runtime de ONNX, que puede provocar que la sincronización labial deje de funcionar al reutilizar generadores después de periodos de silencio.
Por ejemplo, podrías recrear el generador de lip sync en cada inicio de reproducción, como cada vez que llames a Play Sound 2D o uses cualquier otro método para iniciar la reproducción de la onda de sonido y el lip sync:

Ubicación del plugin para la integración de Runtime Text To Speech: Al usar Runtime MetaHuman Lip Sync junto con Runtime Text To Speech (ambos plugins usan ONNX Runtime), es posible que experimentes problemas si los plugins están instalados en la carpeta Marketplace del motor. Para solucionarlo:
- Localiza ambos plugins en tu carpeta de instalación de UE dentro de
\Engine\Plugins\Marketplace(por ejemplo,C:\Program Files\Epic Games\UE_5.6\Engine\Plugins\Marketplace) - Mueve ambas carpetas
RuntimeMetaHumanLipSyncyRuntimeTextToSpeecha la carpetaPluginsde tu proyecto - Si tu proyecto no tiene una carpeta
Plugins, crea una en el mismo directorio que tu archivo.uproject - Reinicia el Unreal Editor
Esto soluciona los problemas de compatibilidad que pueden ocurrir cuando se cargan varios plugins basados en ONNX Runtime desde el directorio Marketplace del motor.
Configuración de empaquetado (Windows): Si la sincronización labial no funciona correctamente en tu proyecto empaquetado en Windows, asegúrate de usar la configuración de compilación Shipping en lugar de Development. La configuración Development puede causar problemas con el runtime ONNX de los modelos realistas en las compilaciones empaquetadas.
Para solucionar esto:
- En la configuración de tu proyecto → Empaquetado, establece la Configuración de compilación en Shipping
- Vuelve a empaquetar tu proyecto

En algunos proyectos que solo usan Blueprint, Unreal Engine puede seguir compilando en configuración Development incluso cuando se selecciona Shipping. Si esto ocurre, convierte tu proyecto en un proyecto de C++ añadiendo al menos una clase de C++ (puede estar vacía). Para ello, ve a Tools → New C++ Class en el menú del editor de UE y crea una clase vacía. Esto forzará que el proyecto se compile correctamente en la configuración Shipping. Tu proyecto puede seguir siendo solo de Blueprint en cuanto a funcionalidad; la clase de C++ solo es necesaria para una configuración de compilación adecuada.
Disminución de la capacidad de respuesta del Lip Sync: Si experimentas que el lip sync se vuelve menos receptivo con el tiempo al usar Streaming Sound Wave o Capturable Sound Wave, esto puede deberse a la acumulación de memoria. De forma predeterminada, la memoria se reasigna cada vez que se añade audio nuevo. Para evitar este problema, llama periódicamente a la función ReleaseMemory para liberar la memoria acumulada, por ejemplo, cada 30 segundos aproximadamente.
Optimización del rendimiento:
- Ajusta el tamaño del fragmento de procesamiento para los modelos Realistic según tus requisitos de rendimiento
- Usa recuentos de hilos adecuados para tu hardware objetivo
- Considera usar el tipo de salida Mouth Only para los modelos con control de estado de ánimo cuando no se necesite animación facial completa